Status do documento: descrição de um processo em implantação (bucket
process-adjustments). Os resultados da Seção IX são esperados, não medidos.
Resumo — Agentes de programação baseados em modelos de linguagem já executam tarefas de engenharia de várias etapas, mas sua adoção em projetos com especificação normativa, como um compilador, esbarra em três problemas: o agente inventa regras por analogia, avalia o próprio trabalho e perde contexto entre sessões. Este artigo descreve o processo de desenvolvimento agêntico adotado no Basic Next, uma linguagem orientada a objetos com interpretador (bni) e compilador nativo (bnc) que compartilham uma representação intermediária validada. O processo combina cinco mecanismos: (i) precedência da especificação sobre a implementação, com um guardião que classifica cada mudança como correção, complemento ou extensão; (ii) separação de papéis — planejador, testador, implementador, revisor e auditor — atribuídos a modelos diferentes por um único arquivo de configuração, o que permite inverter a atribuição conforme a disponibilidade de cada modelo; (iii) unidades de trabalho pequenas (buckets, sprints e atividades) com critérios de aceite que precisam falhar antes da mudança; (iv) regras convertidas em gates executáveis, do hook de edição à integração contínua; e (v) memória do projeto em arquivos versionados num repositório privado, em vez da memória interna de cada ferramenta. O artigo apresenta os objetivos, os componentes, o funcionamento e as métricas com que o processo será avaliado.
Termos de indexação — agentes de software, modelos de linguagem, engenharia de compiladores, desenvolvimento orientado a testes, revisão independente, integração contínua.
I. Introdução
A geração atual de ferramentas de programação deixou de sugerir trechos de código e passou a executar tarefas inteiras: ler um repositório, planejar, editar vários arquivos, rodar testes e iterar até concluir. Ferramentas como Claude Code e Antigravity CLI operam nesse modo, com acesso ao terminal e ao sistema de arquivos.
Num projeto de linguagem de programação, essa autonomia tem um custo específico. A linguagem é definida por uma especificação normativa (gramática, semântica, palavras reservadas), e uma mudança que pareça razoável — aceitar uma sintaxe de outro dialeto, "corrigir" um defeito mudando o que um programa válido faz — é uma alteração da linguagem, não uma correção. O agente não distingue essas situações por conta própria.
No Basic Next, o uso contínuo de agentes ao longo das versões 0.4 a 0.6.12 expôs falhas recorrentes:
- Regra inventada. Propostas que introduziam construções de outros dialetos BASIC ou preenchiam lacunas normativas por analogia.
- Autoavaliação. O mesmo agente implementava, testava e auditava, e defeitos sobreviviam às três etapas.
- Perda de contexto. Buckets de 31 a 35 KB, com dezenas de itens, fizeram as sessões compactarem antes do fechamento.
- Falso verde. Testes executados sobre binários desatualizados e verificações que passavam localmente e falhavam só na integração contínua.
- Instruções divergentes. O brief do agente e as skills repetiam comandos e números que, com o tempo, passaram a se contradizer.
Este artigo descreve o processo que trata essas falhas. A contribuição não é um novo algoritmo, e sim uma composição de práticas conhecidas — especificação normativa, desenvolvimento orientado a testes [3], revisão independente, integração contínua — adaptada a agentes que trocam de sessão, de modelo e de ferramenta.
II. Contexto: o projeto Basic Next
Basic Next é uma linguagem explicitamente tipada e orientada a objetos. A cadeia de ferramentas, escrita em Rust, tem um único frontend compartilhado que produz a representação intermediária BN IR; essa IR é validada uma vez e consumida tanto pelo interpretador bni, que é a referência executável, quanto pelo compilador bnc, que gera código nativo via LLVM.
A ordem de autoridade é fixa: especificação, depois comportamento observável do bni onde a especificação é omissa, depois a documentação de arquitetura. Uma divergência entre a cadeia de ferramentas e a especificação se corrige na cadeia de ferramentas, nunca na especificação. Extensões da linguagem só entram com decisão registrada do mantenedor (modelo BDFL).
O projeto mantém repositórios irmãos dentro de uma pasta comum, bn/, que não é ela própria um repositório: o código (basicnext, público), o livro didático (basicnext-book, público), as extensões de editor e, a partir deste processo, o repositório privado de processo (workflow).
III. Objetivos
O processo persegue seis objetivos, cada um ligado a uma falha da Seção I:
- O1 — Especificação acima do agente. Nenhuma mudança na superfície da linguagem sem classificação explícita e, para extensões, decisão do mantenedor.
- O2 — Nenhum modelo avalia o próprio código. Quem implementa nunca é quem testa, revisa ou audita.
- O3 — Trabalho que cabe numa sessão. Unidades pequenas o bastante para serem concluídas sem compactação de contexto e revisadas por um humano.
- O4 — Regra que importa é executável. Toda regra crítica vira um gate automático; o texto do brief só aponta para ele.
- O5 — Memória compartilhada e auditável. O estado, as decisões e os defeitos ficam em arquivos versionados que qualquer agente lê.
- O6 — Processo privado, produto público. Nenhum arquivo público cita material privado, e nenhum arquivo de processo vai para o repositório público.
IV. Arquitetura do ambiente
A Fig. 1 mostra a organização. Os agentes sempre abrem em bn/, de modo que código, livro e processo ficam no mesmo espaço de trabalho: uma mudança de linguagem e o capítulo correspondente do livro são feitos na mesma sessão.
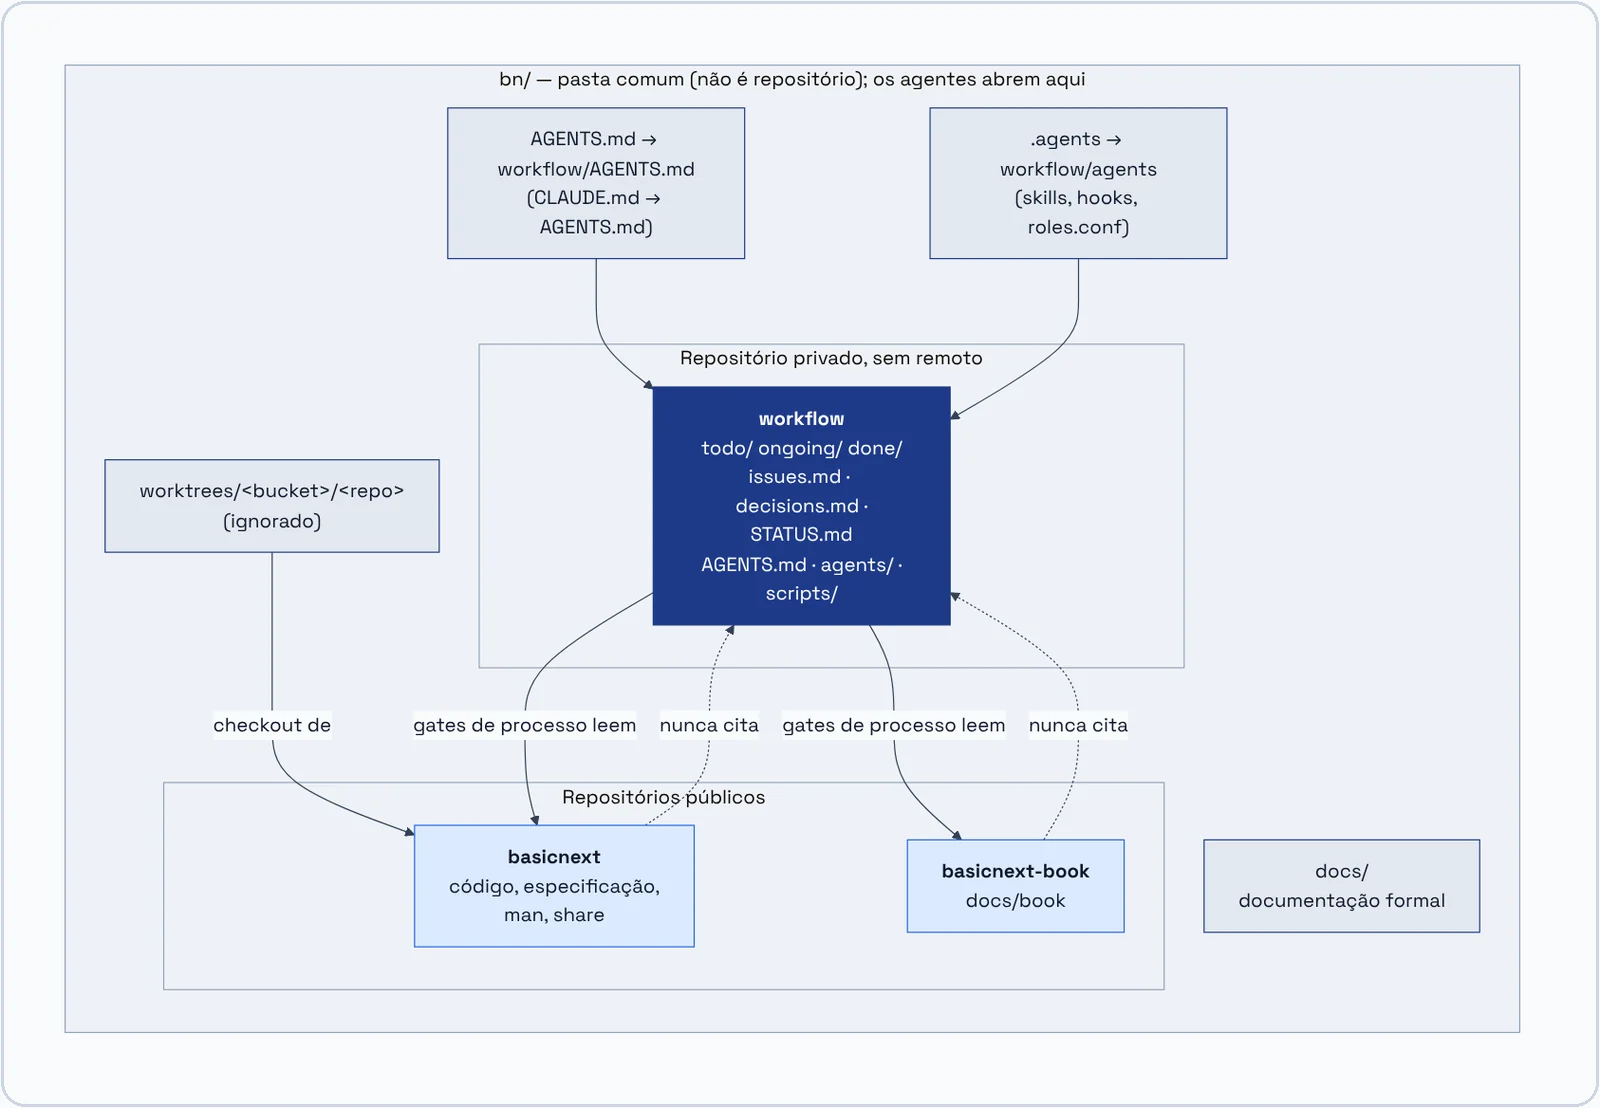
A separação tem duas consequências. Primeiro, um git add -A no repositório público nunca publica um arquivo de processo, porque não há nenhum ali. Segundo, as verificações se dividem em dois conjuntos: os gates de código, que vivem no repositório público e leem só ele, e os gates de processo, que vivem em workflow e leem os repositórios irmãos.
V. Componentes
A. Brief e skills
O AGENTS.md contém as regras estáveis do projeto e é carregado em toda sessão. As skills são pastas com um SKILL.md que descreve um procedimento; o agente vê apenas nome e descrição no início e carrega o conteúdo quando a tarefa corresponde. O processo impõe uma regra de autoridade: o brief define, as skills apenas detalham, e nenhuma skill repete um número, caminho, lista de pacotes ou comando que o brief ou um script já possui. A Antigravity CLI trunca arquivos de regra acima de 24.000 bytes e limita o conjunto de regras sempre ativas a 20.000 tokens [6], o que torna esse enxugamento uma necessidade técnica, não só estética.
B. Guardião da linguagem
A skill language-guardian aplica um procedimento a toda mudança que toque a superfície da linguagem: nomear a superfície, citar a norma, verificar o vocabulário contra a gramática e as palavras reservadas, classificar a mudança e exigir evidência. Só correções e complementos prosseguem; extensões são bloqueadas até decisão do mantenedor, e conflitos entre fontes normativas são relatados com opções, nunca resolvidos pelo agente.
C. Unidades de trabalho
| Nível | Tamanho | Limite que governa |
|---|---|---|
| Atividade | 1 commit; cerca de 300–400 linhas de código de produção; 1 critério testável | Revisão humana |
| Sprint | 2–5 atividades; uma sessão sem compactação; termina num gate | Contexto do agente |
| Bucket | 1 tema; 2–4 sprints; cerca de 8–15 atividades | Coerência de revisão e release |
Um bucket é um arquivo markdown cuja lista de atividades é o plano. Só arquivos executados por um agente levam o prefixo bucket-; notas de desenho, planos e relatórios ficam em arquivos separados. Cada atividade tem campos com dono definido: Kind (a classificação do guardião), Touches, Acceptance (escrito antes do trabalho e que precisa falhar na árvore atual), Test e Evidence.
D. Papéis e o arquivo de papéis
O processo define cinco papéis. A atribuição padrão está na Tabela II, mas ela vive num único arquivo, roles.conf, e pode ser invertida editando uma linha — por exemplo, quando um dos modelos fica sem cota.
| Papel | Responsabilidade | Atribuição padrão |
|---|---|---|
| Planejador | escopo, critério de aceite, veredito do guardião | Claude |
| Testador | teste vermelho do critério, positivo e negativo, nos dois backends | Claude |
| Implementador | código até os testes passarem, sem editar testes | Gemini (Antigravity CLI) |
| Revisor | revisão independente, inclusive se os testes provam o critério | Claude Opus, sessão nova |
| Auditor | auditoria de defeitos, segurança e concorrência no fechamento da sprint | Claude Opus, sessão nova |
A Fig. 2 mostra como um agente decide o que pode fazer numa sessão.
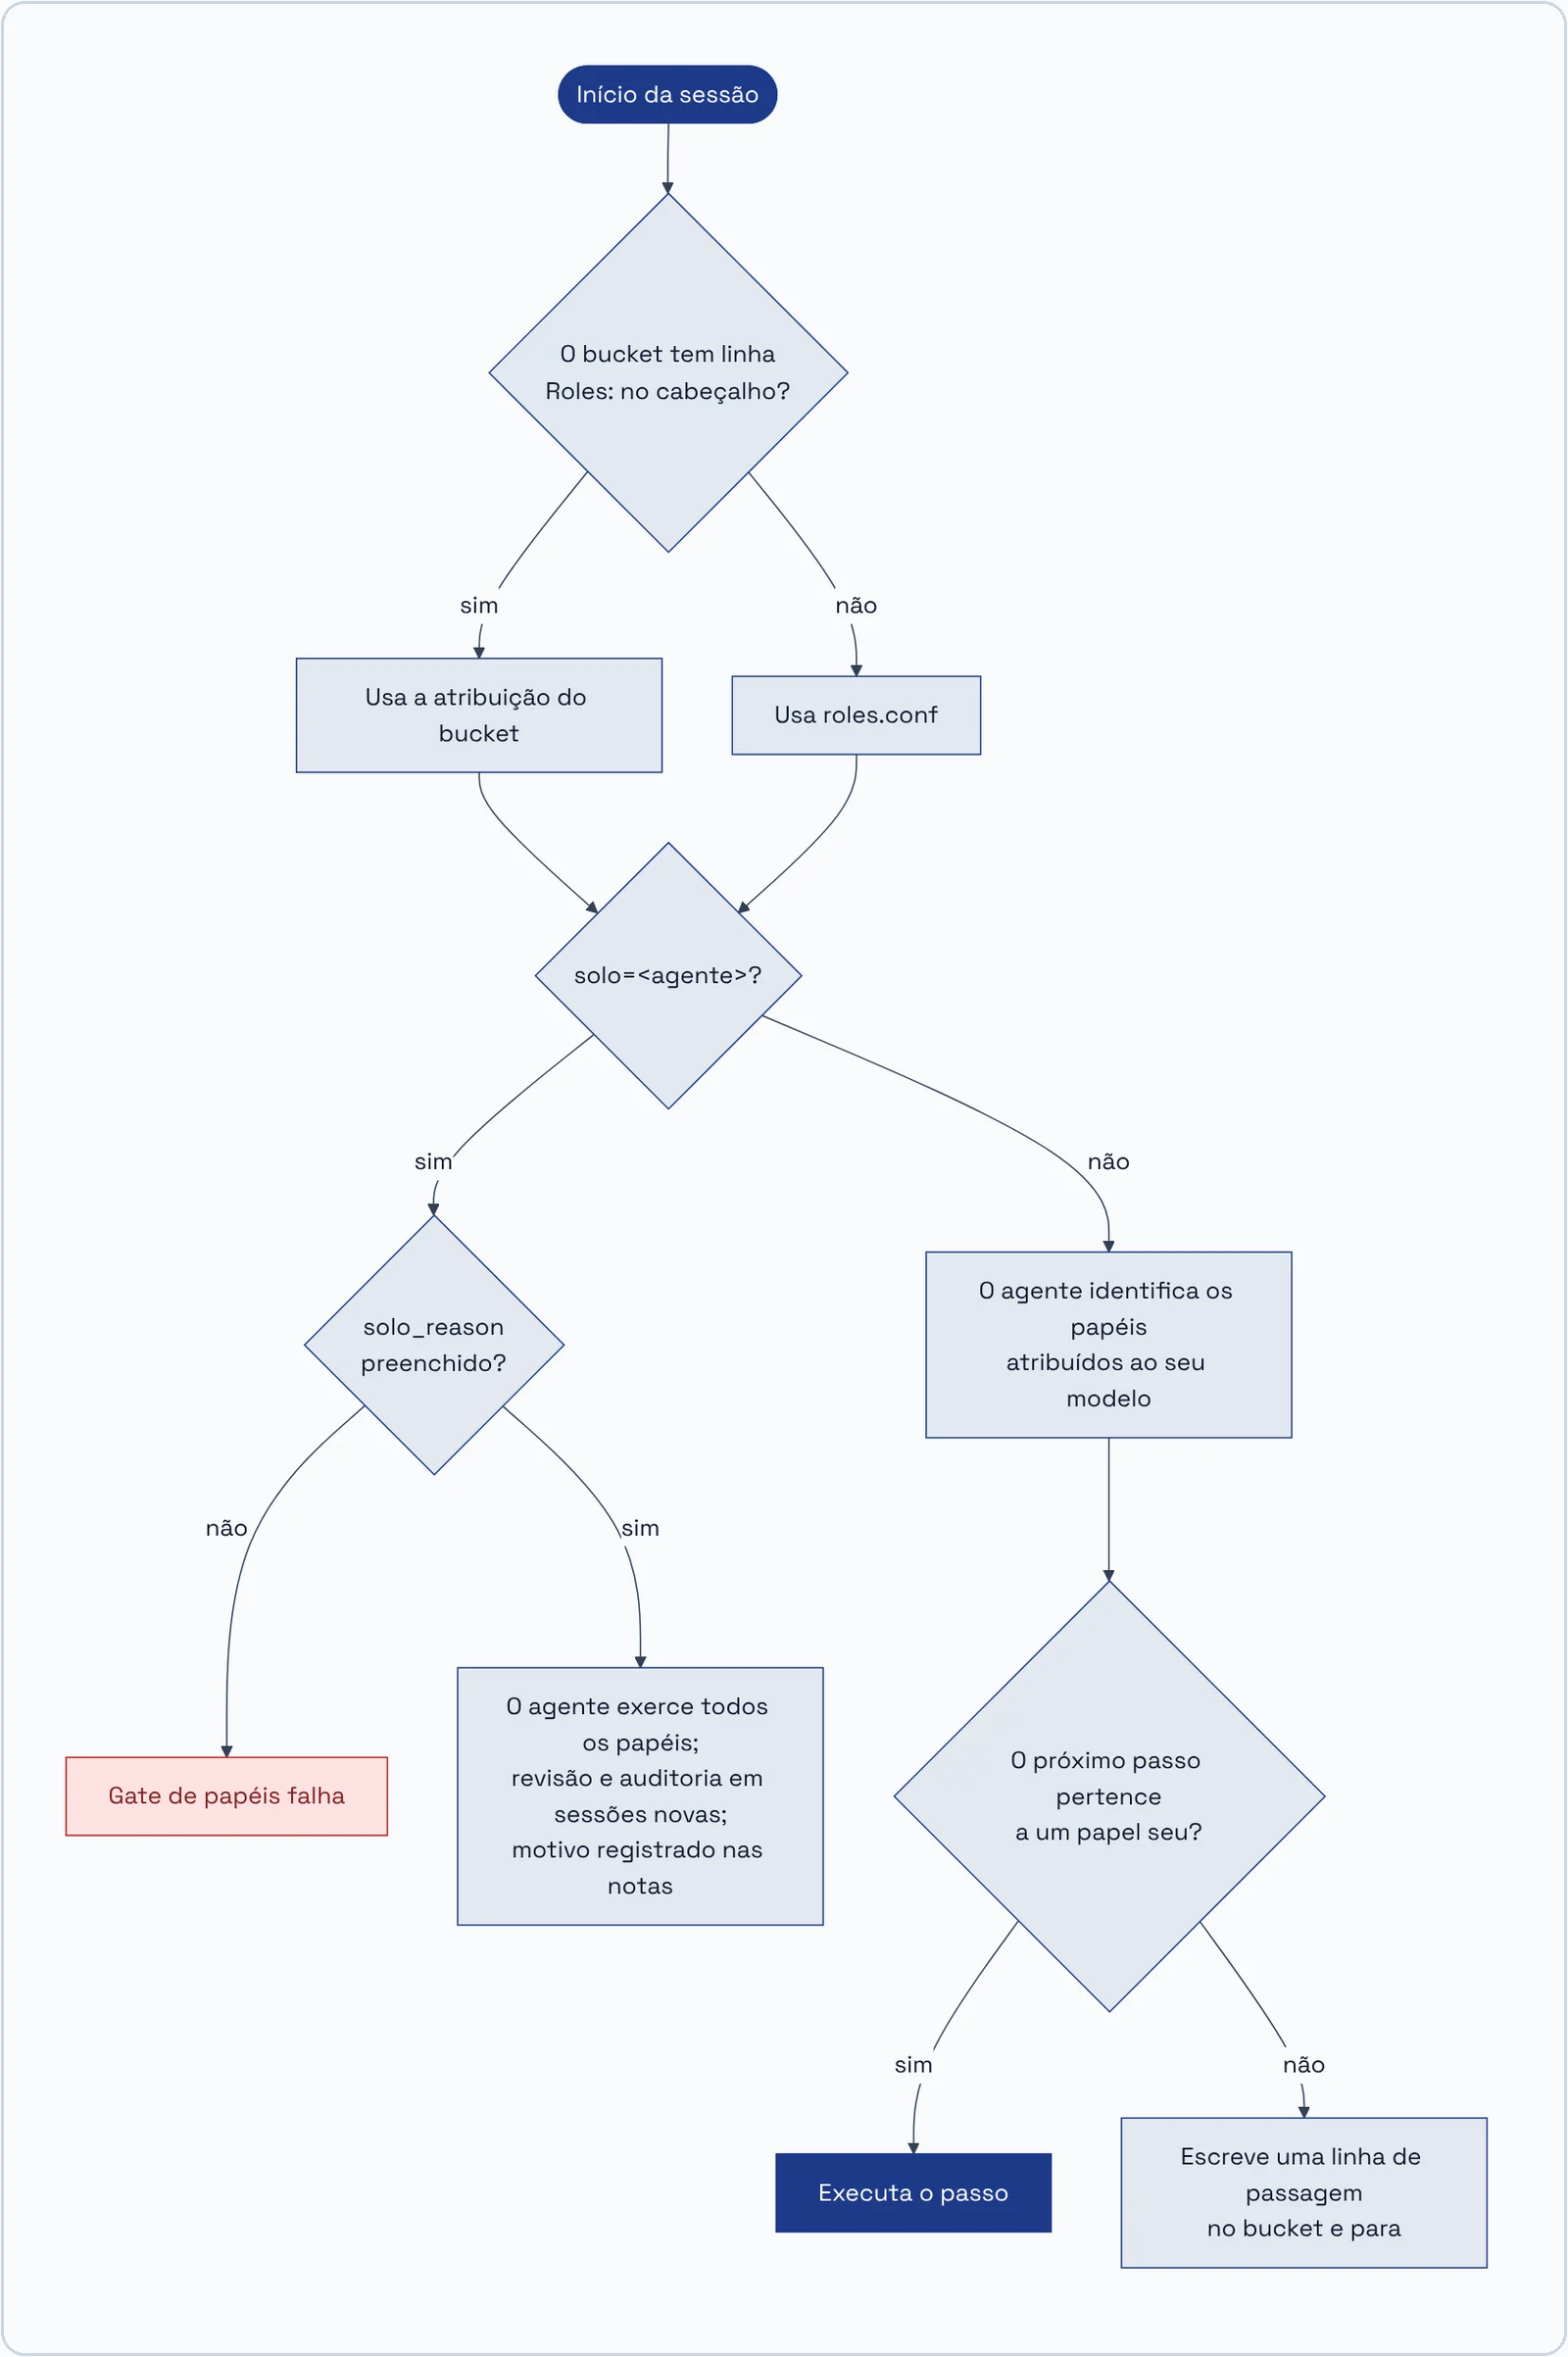
Três regras valem para qualquer atribuição: o implementador nunca é testador, revisor ou auditor; o implementador nunca edita um teste da própria atividade; e o bucket é o único canal de passagem entre agentes. Cada commit leva os trailers Role: e Agent:, e um gate confere se o papel declarado é dono de todos os caminhos alterados.
E. Gates
Um gate é uma verificação automática que bloqueia o avanço. O processo os organiza em camadas, da mais rápida à mais completa (Fig. 3).
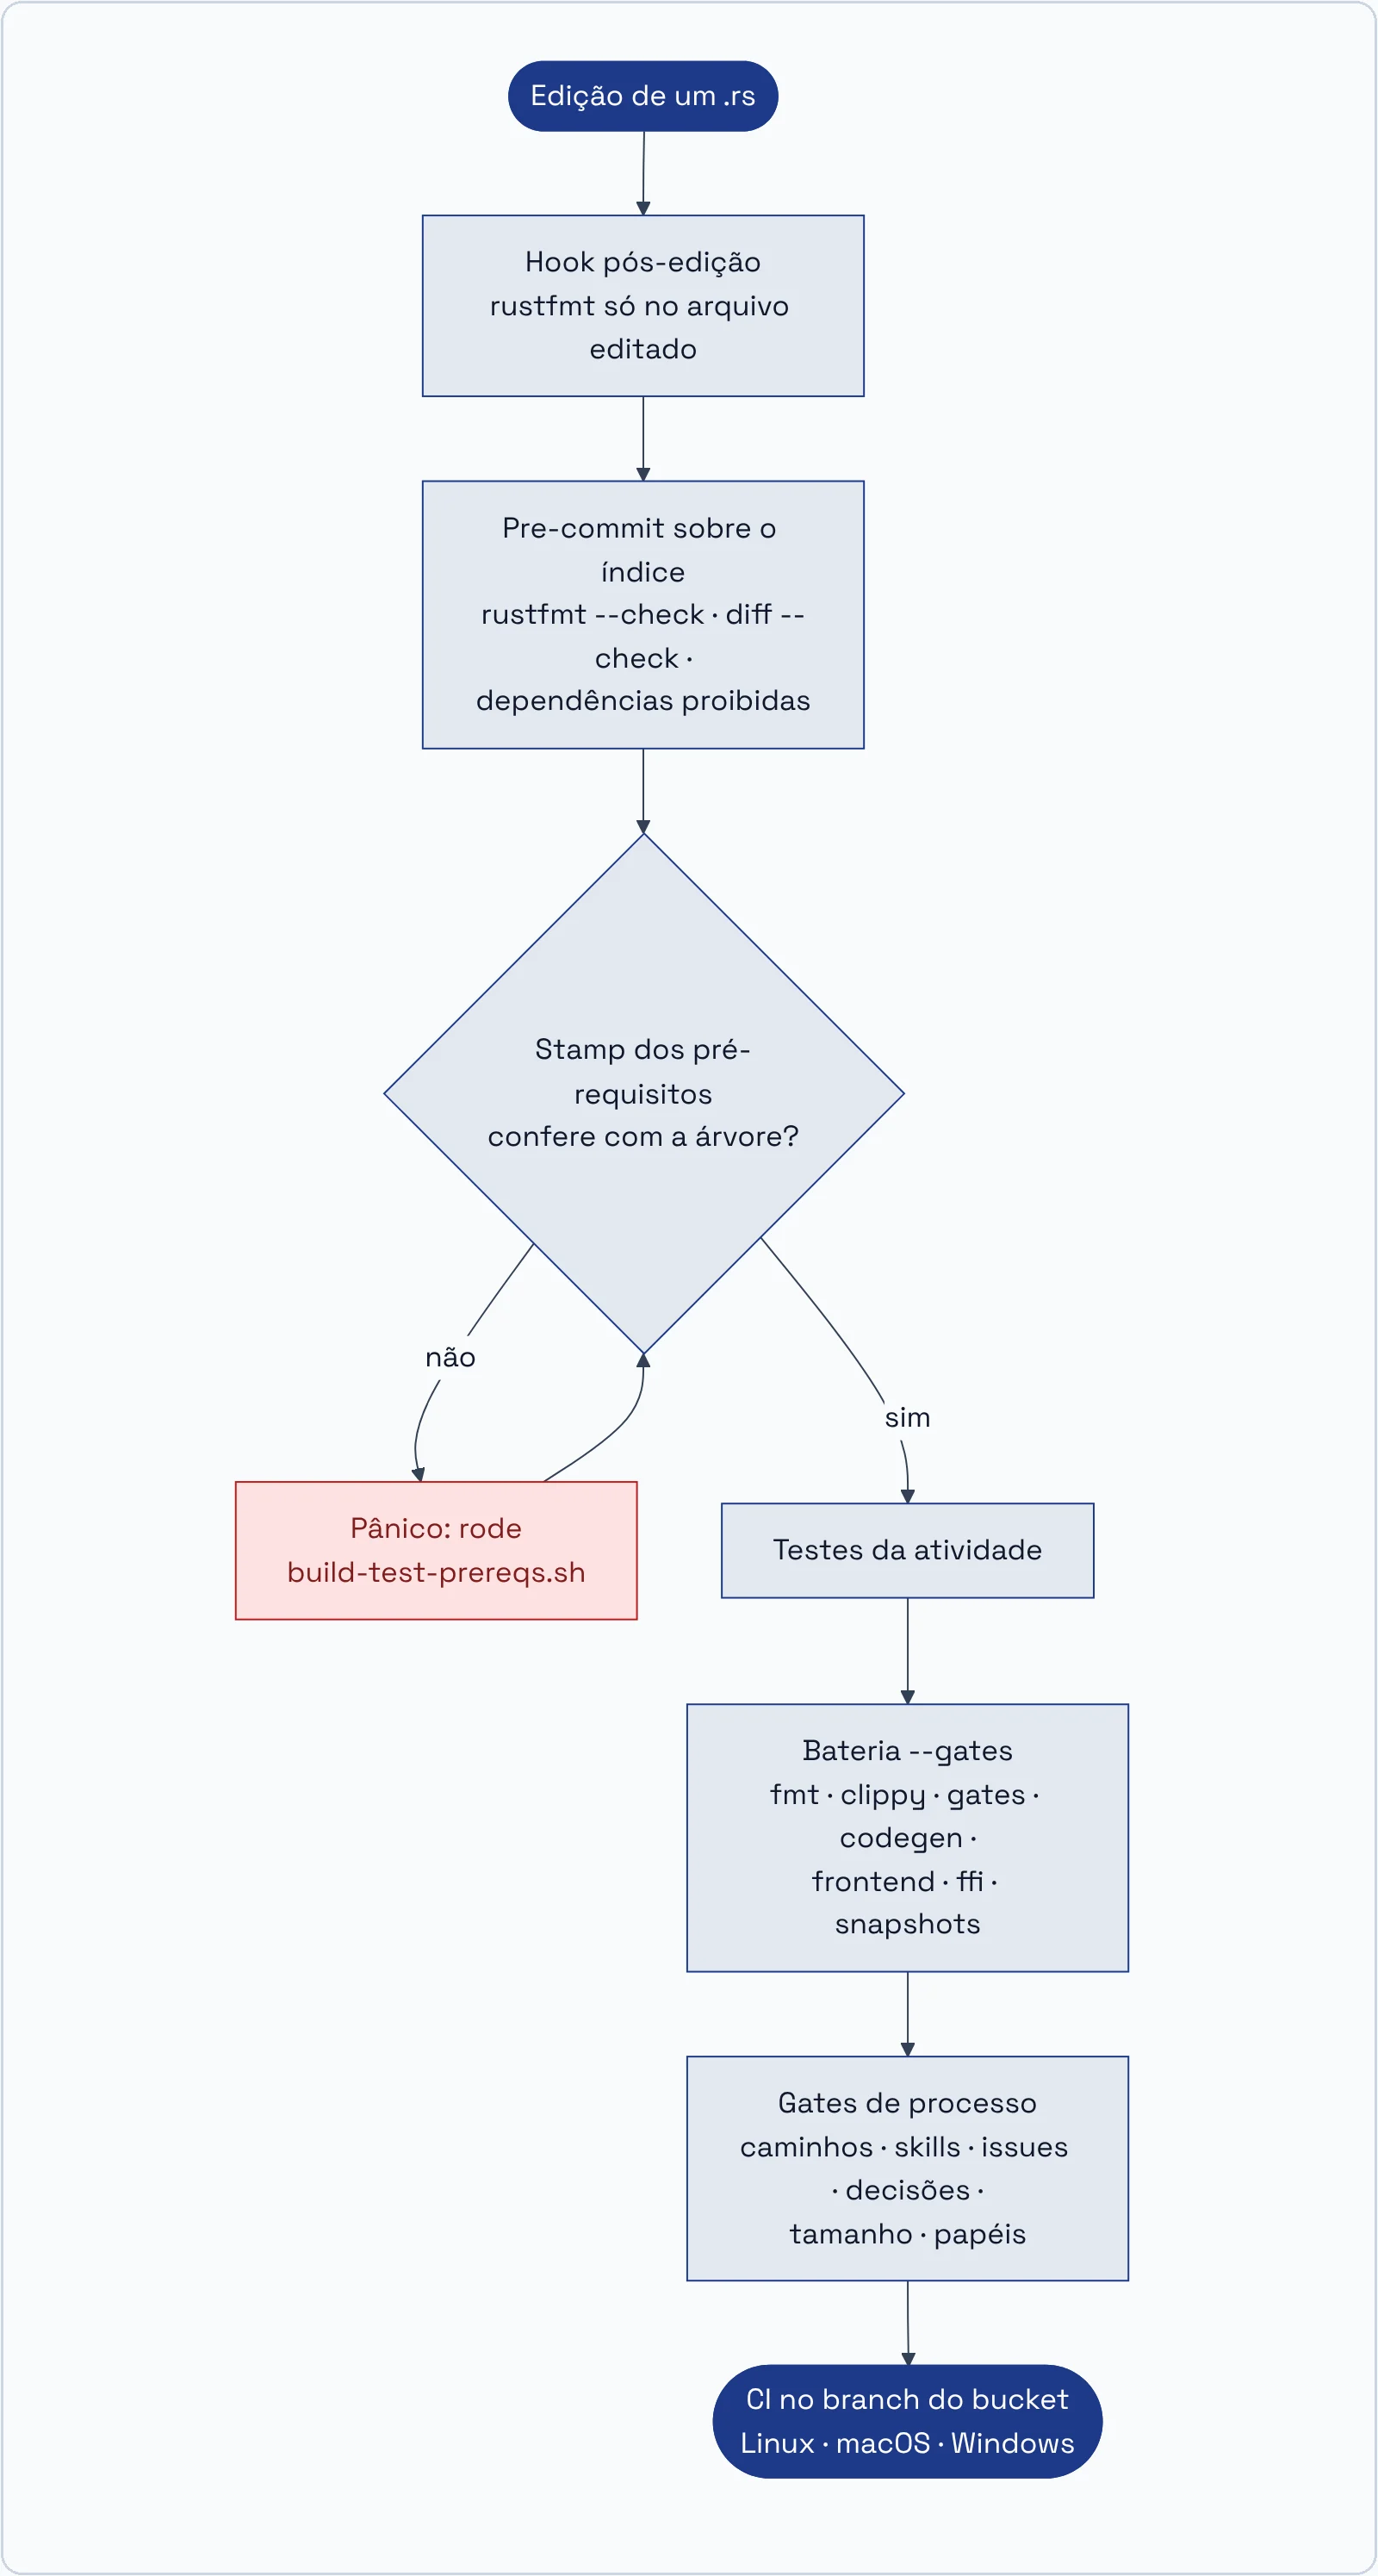
Alguns gates merecem destaque:
- Stamp de pré-requisitos. O script de pré-requisitos grava, após compilar, um hash do estado da árvore (o commit atual, o diff incluindo o que está em stage e o conteúdo dos arquivos não rastreados). O auxiliar dos testes recalcula o hash e falha com uma mensagem explícita se ele divergir. Comparar datas de arquivos não serve: o Cargo só refaz o link de um binário quando uma dependência dele muda, e uma edição num crate que o binário não usa o deixaria "desatualizado" para sempre.
- Pre-commit sobre o índice. O hook formata e verifica apenas o que está no commit (
git show :<caminho>), nunca a árvore de trabalho, para não travar nem alterar trabalho alheio não commitado. - Catraca de referências privadas. O gate que proíbe citações de material privado em arquivos públicos começa com uma lista de arquivos e contagens que só pode diminuir, como o gate de tamanho de arquivo já existente. Isso permite introduzir a regra antes de limpar as cerca de 300 linhas existentes.
F. Memória em arquivos
A memória interna de cada ferramenta é invisível para a outra quando os papéis se invertem, não tem histórico e pode guardar uma conclusão errada sem que ninguém veja. O processo a substitui por arquivos em workflow (Fig. 4).
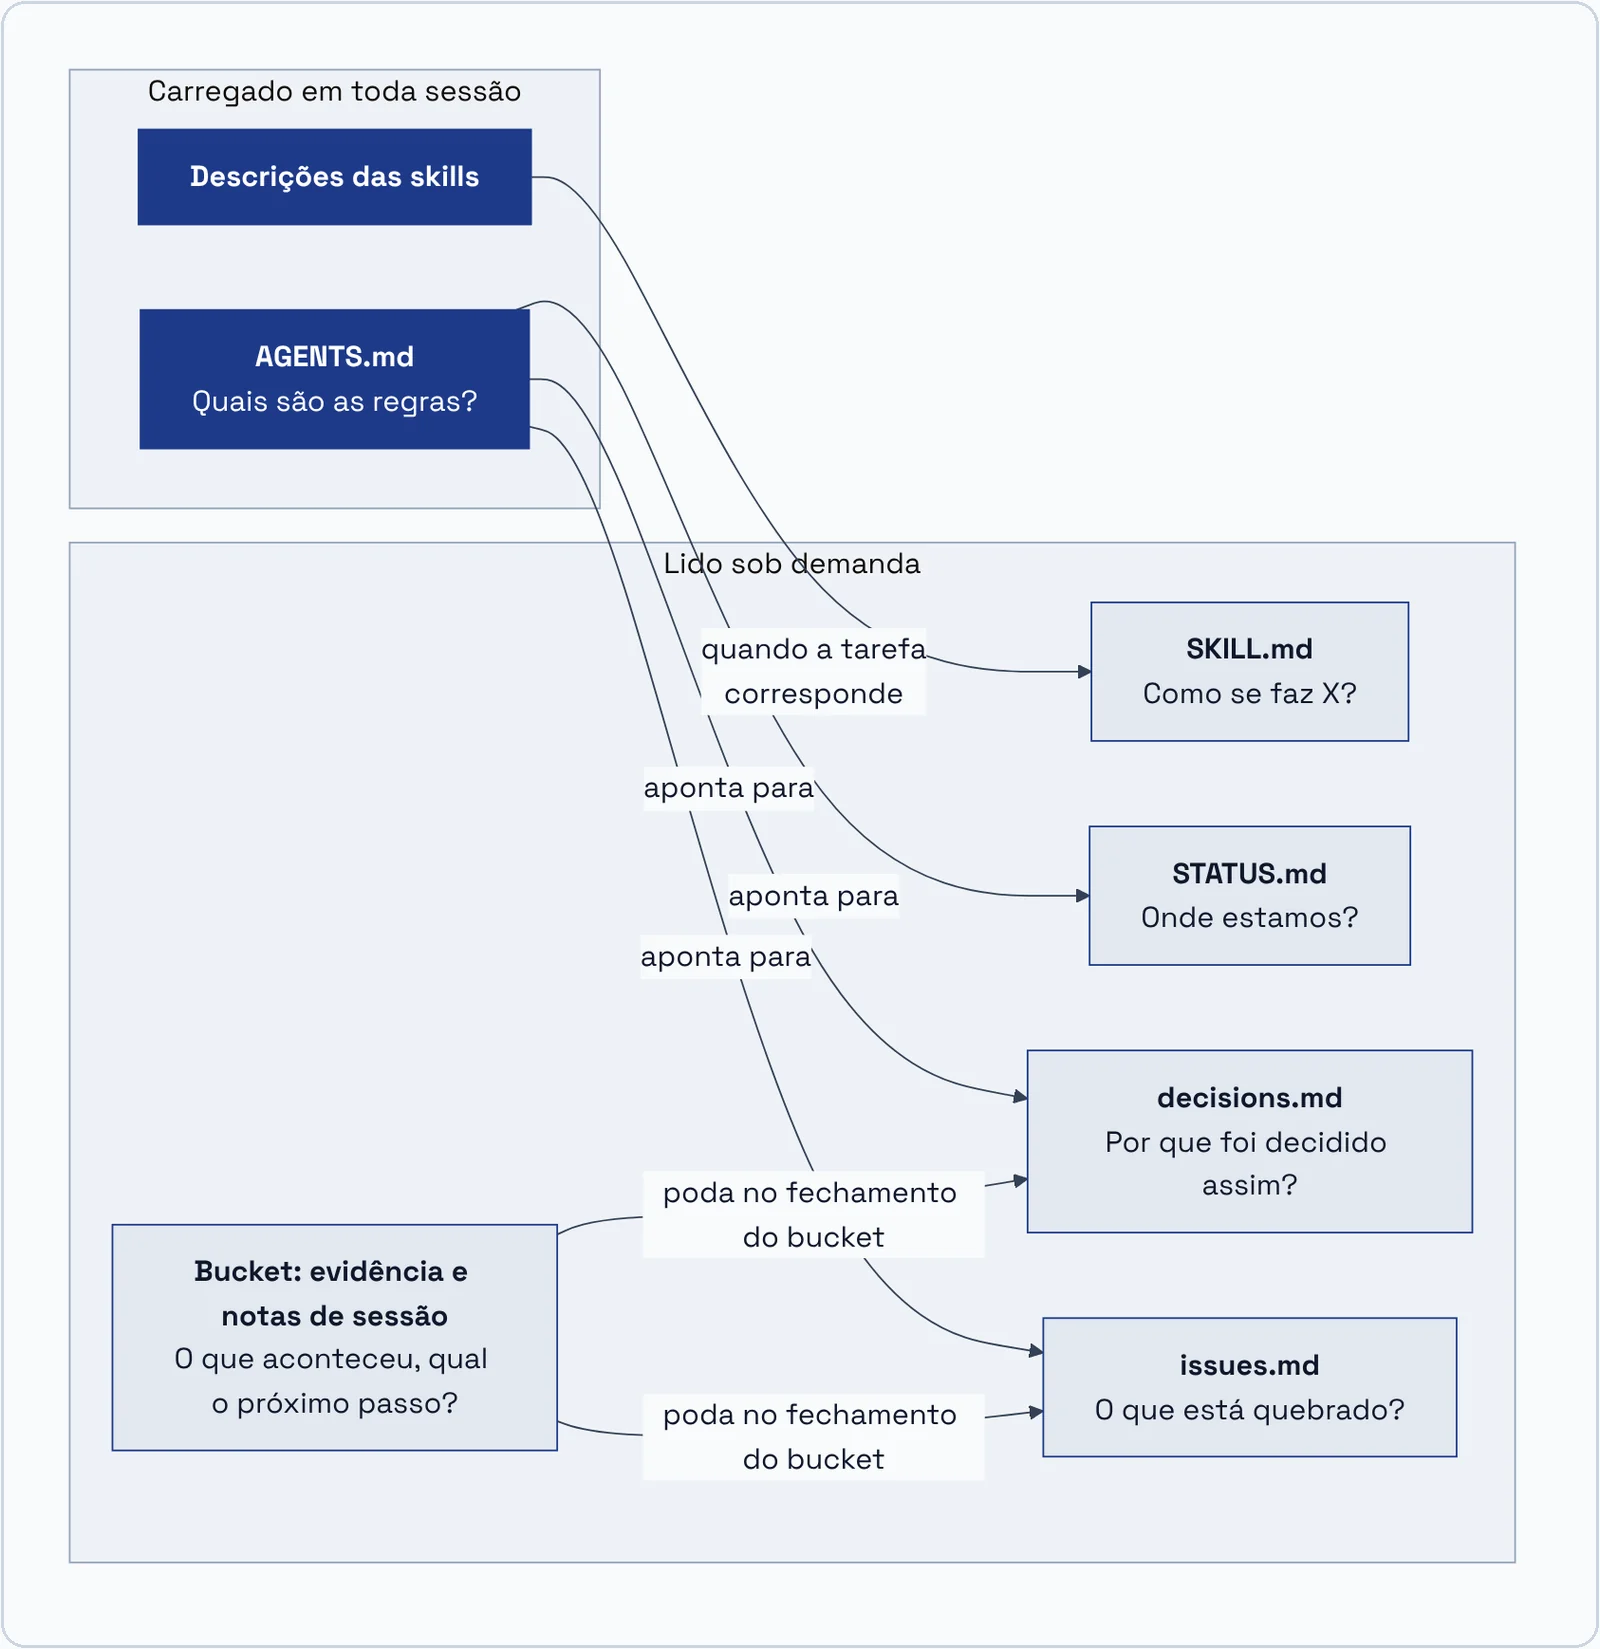
A memória é escrita em pontos fixos: a evidência ao marcar uma atividade como concluída, uma linha de passagem ao final de cada sessão e o STATUS.md no fechamento da sprint. Uma lição aprendida vira primeiro um teste ou gate; só quando isso não é possível ela vira uma linha datada numa skill. No fechamento de cada bucket, o planejador poda as notas de sessão.
VI. Funcionamento
A. Ciclo de vida de um bucket
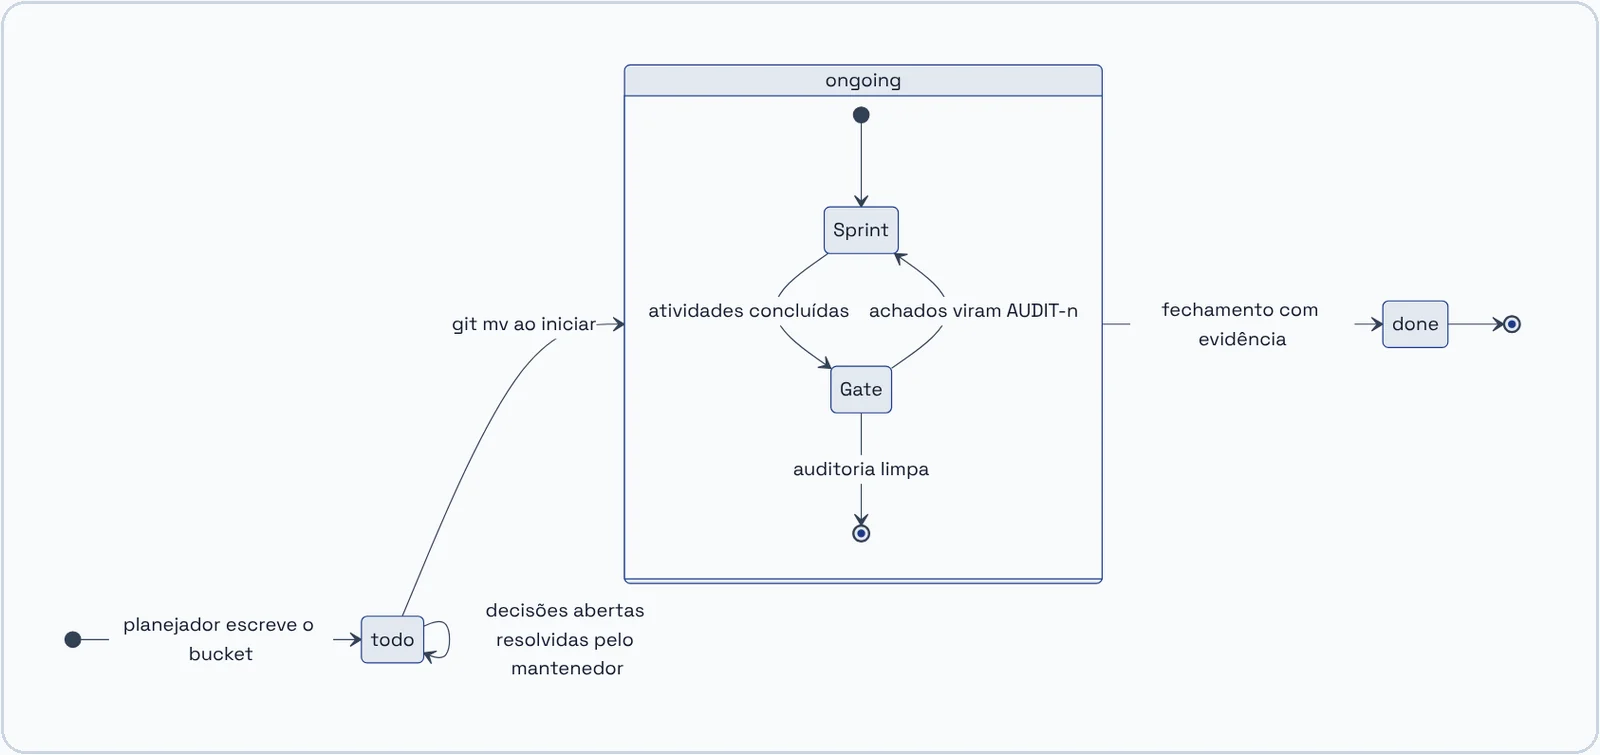
B. Ciclo de uma atividade entre agentes
A Fig. 6 mostra uma atividade completa com a atribuição padrão. O ponto central é que o teste vermelho existe antes do código, escrito por um modelo diferente do que vai implementar.
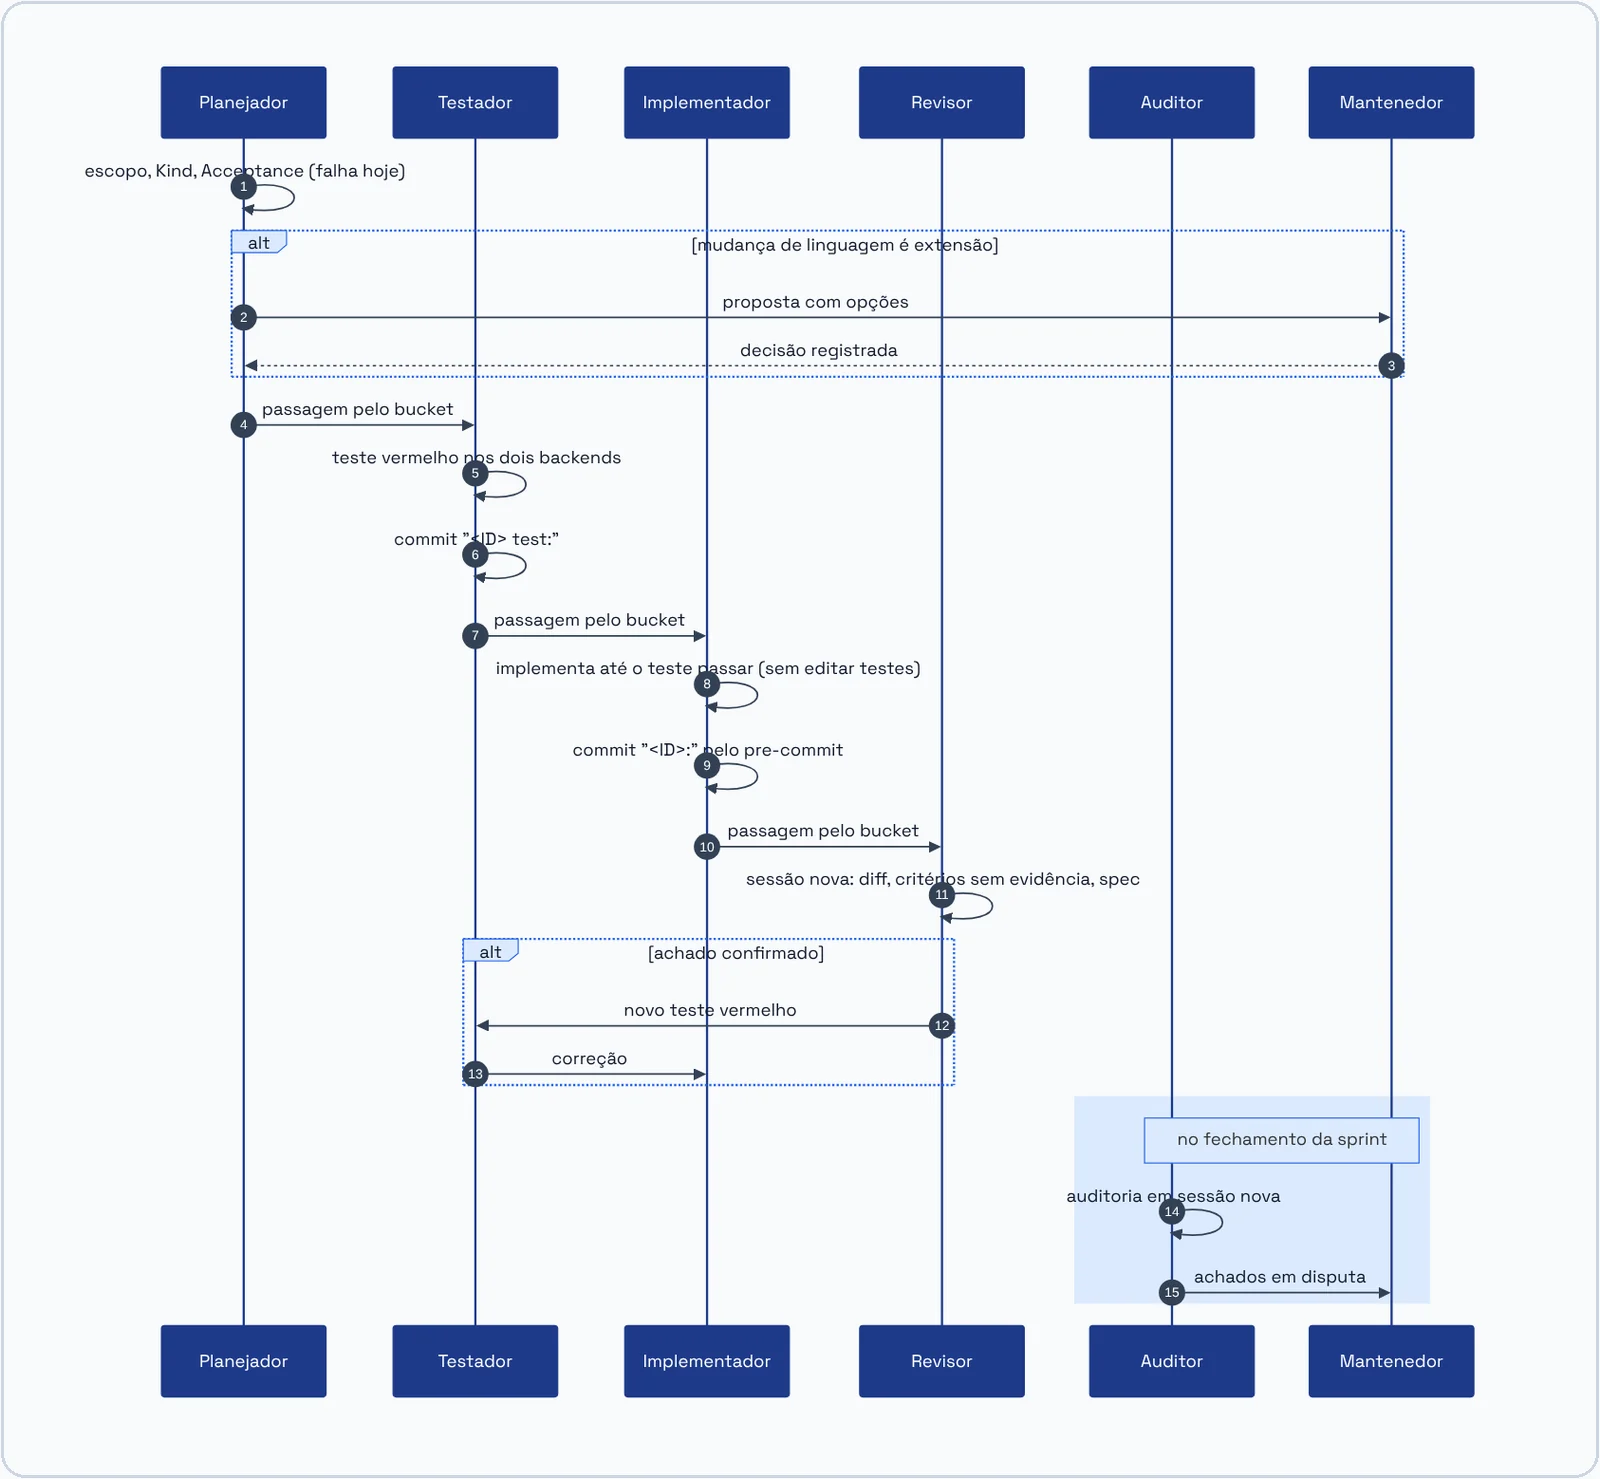
Cada atividade gera commits identificados pelo ID (P3: …, P3 test: …, AUDIT-2: …) num branch do bucket. Todo commit precisa compilar; só o commit de teste pode falhar nos próprios testes novos, e a busca binária por regressões (git bisect) os pula. Quando a atividade altera a linguagem, ela também gera um commit no repositório do livro, com o mesmo ID.
C. Inversão de papéis
Para inverter a atribuição — por exemplo, Claude implementando e Gemini testando —, o mantenedor edita roles.conf e faz o commit. Nenhum outro arquivo muda, porque o brief e as skills falam em papéis, não em modelos. O script de revisão lê o papel reviewer e chama o comando do agente correspondente, já com o modelo fixado. Em caso de cota esgotada nas duas direções, o modo solo permite um único agente, com motivo obrigatório e revisão em sessões novas.
VII. Garantias e como são verificadas
| Objetivo | Mecanismo | Verificação |
|---|---|---|
| O1 | language-guardian; especificação antes do código | Veredito registrado no bucket; fixtures positivas e negativas nos dois backends |
| O2 | Papéis distintos; trailers | Gate de papéis: papel dono de cada caminho; implementador não toca testes |
| O3 | Faixas da Tabela I; linha de passagem | Aviso de tamanho; registro de compactação nas notas |
| O4 | Hooks, pre-commit, stamp, bateria, CI | Cada gate tem um defeito plantado no próprio teste |
| O5 | Arquivos em workflow | Gates de log de issues e de decisões; retomada sem histórico de conversa |
| O6 | Repositório privado; catraca de citações | Gate de referências privadas no repositório público |
Uma regra transversal sustenta a tabela: todo critério de aceite precisa poder falhar. Ele falha na árvore atual, ou num defeito plantado, e passa depois da atividade. Um critério como "a CI está verde" só mostra que nada quebrou. Essa regra foi aplicada ao próprio bucket de implantação: uma revisão antes da primeira sprint encontrou um critério que já passava (o script de pré-requisitos existia, embora não fosse usado pela CI) e uma contagem de citações privadas cerca de cinco vezes menor que a real, e o bucket foi reconstruído antes de qualquer código ser escrito.
VIII. Implantação
O processo é implantado por um bucket próprio, executado pelo Claude Code em modo solo, porque a Antigravity CLI só é verificada na última sprint. A Fig. 7 mostra a ordem.
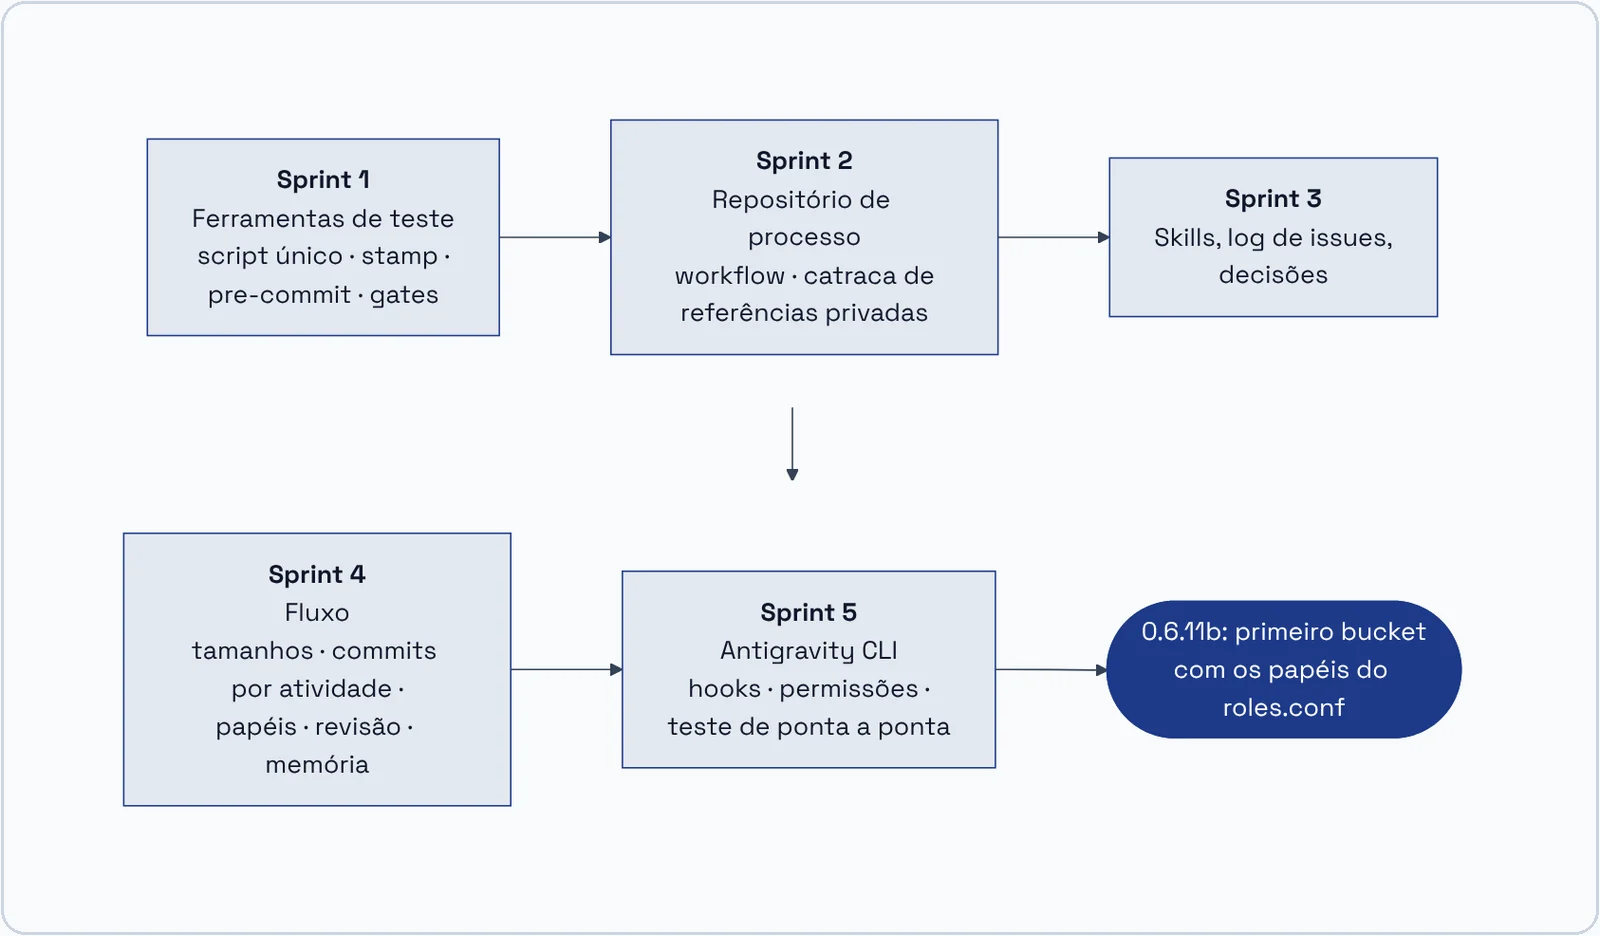
A última sprint é um teste de aceitação da troca de ferramenta: raiz do espaço de trabalho, carregamento único do brief sem truncamento, carregamento das skills pela descrição, permissões do host Windows de testes, comportamento do modo não interativo diante de uma regra que exige aprovação, e uma atividade de ponta a ponta atravessando os papéis.
IX. Resultados esperados
Os resultados serão medidos no bucket 0.6.14, o primeiro executado integralmente com o processo, contra a linha de base dos buckets 0.6.11 e 0.6.12.
| Métrica | Linha de base (0.6.11 e 0.6.12) | Meta |
|---|---|---|
| Falhas de CI após bateria local verde | 2 | 0 |
| Testes executados sobre pré-requisitos desatualizados | não detectados; ≥ 1 caso observado | detectados todos; tendência a 0 |
| Achados da revisão independente não vistos pela auditoria do implementador | sem revisão independente | ≥ o defeito plantado na calibração; contagem por sprint |
| Reversões que atingem uma única atividade | impossível (um commit por bucket) | toda reversão atinge um único commit de atividade |
| Sessões compactadas antes do gate da sprint | 2 de 2 buckets | 0 |
| Tamanho do arquivo de bucket | 31–35 KB | ≤ 10 KB |
| Citações privadas em arquivos públicos | cerca de 300 linhas | lista da catraca vazia |
A calibração da revisão independente usa defeitos reais já corrigidos — um bloqueio na cópia de FIFO na 0.6.12 e um vazamento de buffer de string no bnc — reintroduzidos num branch descartável. Um revisor só é considerado apto se encontrar o defeito plantado. O custo em tokens de cada revisão é registrado por sprint para definir, depois, um teto de gasto.
X. Limitações e riscos
- Testador e auditor do mesmo modelo. Na atribuição padrão, o Claude escreve os testes e também revisa e audita. Uma leitura errada de um critério pode sobreviver no teste e na auditoria. A mitigação é rodar a auditoria numa sessão que não escreveu os testes, conferir cada teste contra o texto da especificação e não contra a evidência do bucket, e deixar os achados em disputa para o mantenedor.
- Custo de passagem. Dois agentes leem o mesmo bucket e a mesma especificação, e cada passagem é uma fronteira de sessão. O processo troca velocidade por independência.
- Dependência de comportamento não documentado. A raiz do espaço de trabalho da Antigravity CLI numa pasta que contém vários repositórios, e o tratamento de regras que exigem aprovação no modo não interativo, não estão documentados [6] e são verificados empiricamente.
- Ponto único de armazenamento. O repositório de processo não tem remoto e a documentação formal fica fora de qualquer repositório; a cópia de segurança depende da máquina do mantenedor.
- Excesso de regras. O próprio processo acumula regras. A defesa é a hierarquia (brief define, skills detalham), a conversão de regras em gates e a poda no fechamento de cada bucket.
XI. Trabalhos futuros
Três direções seguem naturalmente: medir as métricas da Tabela IV ao longo de vários buckets e não de um só; estudar se a inversão de papéis altera a taxa de defeitos encontrados, o que diz algo sobre a complementaridade dos modelos; e relacionar o processo à questão de pesquisa sobre validação do alinhamento entre agentes e especificação, para a qual o Basic Next serve de artefato.
XII. Conclusão
O processo descrito não depende de um modelo mais capaz, e sim de estrutura em volta do modelo: uma especificação que manda, papéis que impedem a autoavaliação, unidades de trabalho que cabem numa sessão, regras que se executam e uma memória que qualquer agente lê. Em termos da classificação clássica de agentes [1], cada agente de programação é um agente baseado em objetivos que não aprende entre sessões; o aprendizado do sistema fica no ambiente — os testes e o revisor fazem o papel de crítico, e os logs de decisões e defeitos fazem o papel de memória.
Agradecimentos
O texto deste artigo e o desenho do processo foram elaborados com o auxílio do assistente Claude, da Anthropic, sob a direção do autor, que tomou todas as decisões registradas.
Referências
- S. Russell e P. Norvig, Artificial Intelligence: A Modern Approach, 4.ª ed. Hoboken, NJ, EUA: Pearson, 2020.
- C. E. Jimenez et al., "SWE-bench: Can language models resolve real-world GitHub issues?", em Proc. Int. Conf. Learn. Represent. (ICLR), 2024.
- K. Beck, Test-Driven Development: By Example. Boston, MA, EUA: Addison-Wesley, 2002.
- R. C. Martin, Clean Code: A Handbook of Agile Software Craftsmanship. Upper Saddle River, NJ, EUA: Prentice Hall, 2008.
- Software and Systems Engineering — Software Testing, ISO/IEC/IEEE 29119, 2013–2022.
- Google, "Antigravity documentation: Rules, Skills, Hooks, Permissions, CLI reference". Acesso em: 29 out. 2026. [Online]. Disponível: https://antigravity.google/docs
- Anthropic, "Claude Code documentation". Acesso em: 29 out. 2026. [Online]. Disponível: https://docs.claude.com
- "AGENTS.md: a simple, open format for guiding coding agents". Acesso em: 29 out. 2026. [Online]. Disponível: https://agents.md